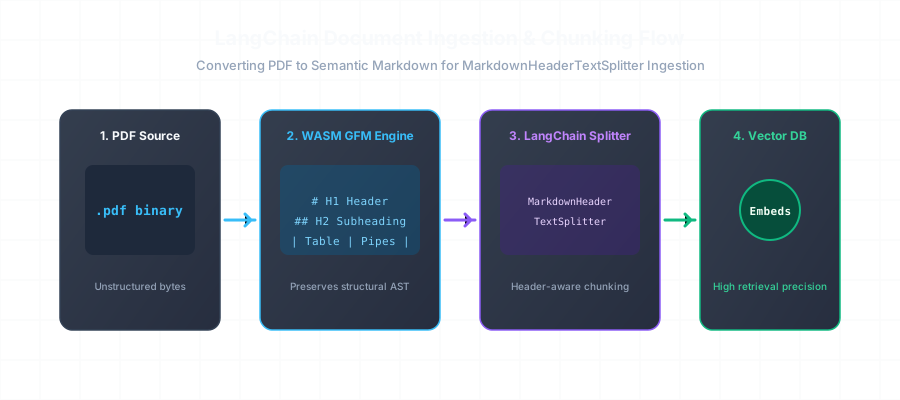
Python Code: Building a Hierarchical Index with Markdown
Execute this snippet to convert and index PDFs into a hierarchical node tree:
from llama_index.core import Document, VectorStoreIndex
from llama_index.core.node_parser import MarkdownNodeParser
import pdftomarkdown

# 1. Convert PDF to Markdown
md_text = pdftomarkdown.convert("system_spec.pdf", extract_tables=True)
doc = Document(text=md_text, metadata={"source": "system_spec.pdf"})

# 2. Parse into hierarchical Markdown nodes
parser = MarkdownNodeParser()
nodes = parser.get_nodes_from_documents([doc])

# 3. Build Vector Store Index with rich structural lineage
index = VectorStoreIndex(nodes)
query_engine = index.as_query_engine()
response = query_engine.query("Explain the security authentication requirements")
print(response)